Microservices Security Cheat Sheet
Введение
Архитектура микросервисов всё активнее используется для проектирования и реализации прикладных систем как в облачных, так и в локальных инфраструктурах, в высоконагруженных приложениях и сервисах. В процессе проектирования и разработки необходимо решить множество задач, связанных с безопасностью. Фундаментальными требованиями безопасности, которые должны быть проработаны на этапе проектирования, являются аутентификация и авторизация. Поэтому для архитекторов безопасности приложений крайне важно понимать и правильно применять существующие архитектурные паттерны при реализации аутентификации и авторизации в системах на основе микросервисов. Цель данного руководства — выявить такие паттерны и дать архитекторам безопасности приложений рекомендации о возможных способах их использования.
Авторизация на уровне edge
В простых сценариях авторизация может осуществляться только на уровне edge (API gateway). API gateway можно использовать для централизованного применения авторизации ко всем нижестоящим микросервисам, что исключает необходимость реализовывать аутентификацию и контроль доступа для каждого отдельного сервиса. В таких случаях NIST рекомендует внедрять компенсирующие меры защиты, например взаимную аутентификацию, для предотвращения прямых анонимных подключений к внутренним сервисам (обхода API gateway). Следует отметить, что авторизация на уровне edge имеет следующие ограничения:
- Перенос всех решений об авторизации на API gateway может быстро стать трудноуправляемым в сложных экосистемах с множеством ролей и правил контроля доступа.
- API gateway может стать единственной точкой принятия решений, что нарушает принцип «глубокоэшелонированной защиты» (defense in depth).
- Как правило, API gateway находится в ведении операционных команд, поэтому команды разработчиков не могут напрямую вносить изменения в авторизацию, что замедляет работу из-за дополнительных коммуникационных и процессных издержек.
В большинстве случаев команды разработчиков реализуют авторизацию в обоих местах — на уровне edge на укрупнённом уровне детализации и на уровне сервиса. Для аутентификации внешней сущности edge может использовать токены доступа (ссылочный токен или self-contained токен), передаваемые через HTTP-заголовки (например, «Cookie» или «Authorization»), либо mTLS.
Авторизация на уровне сервиса
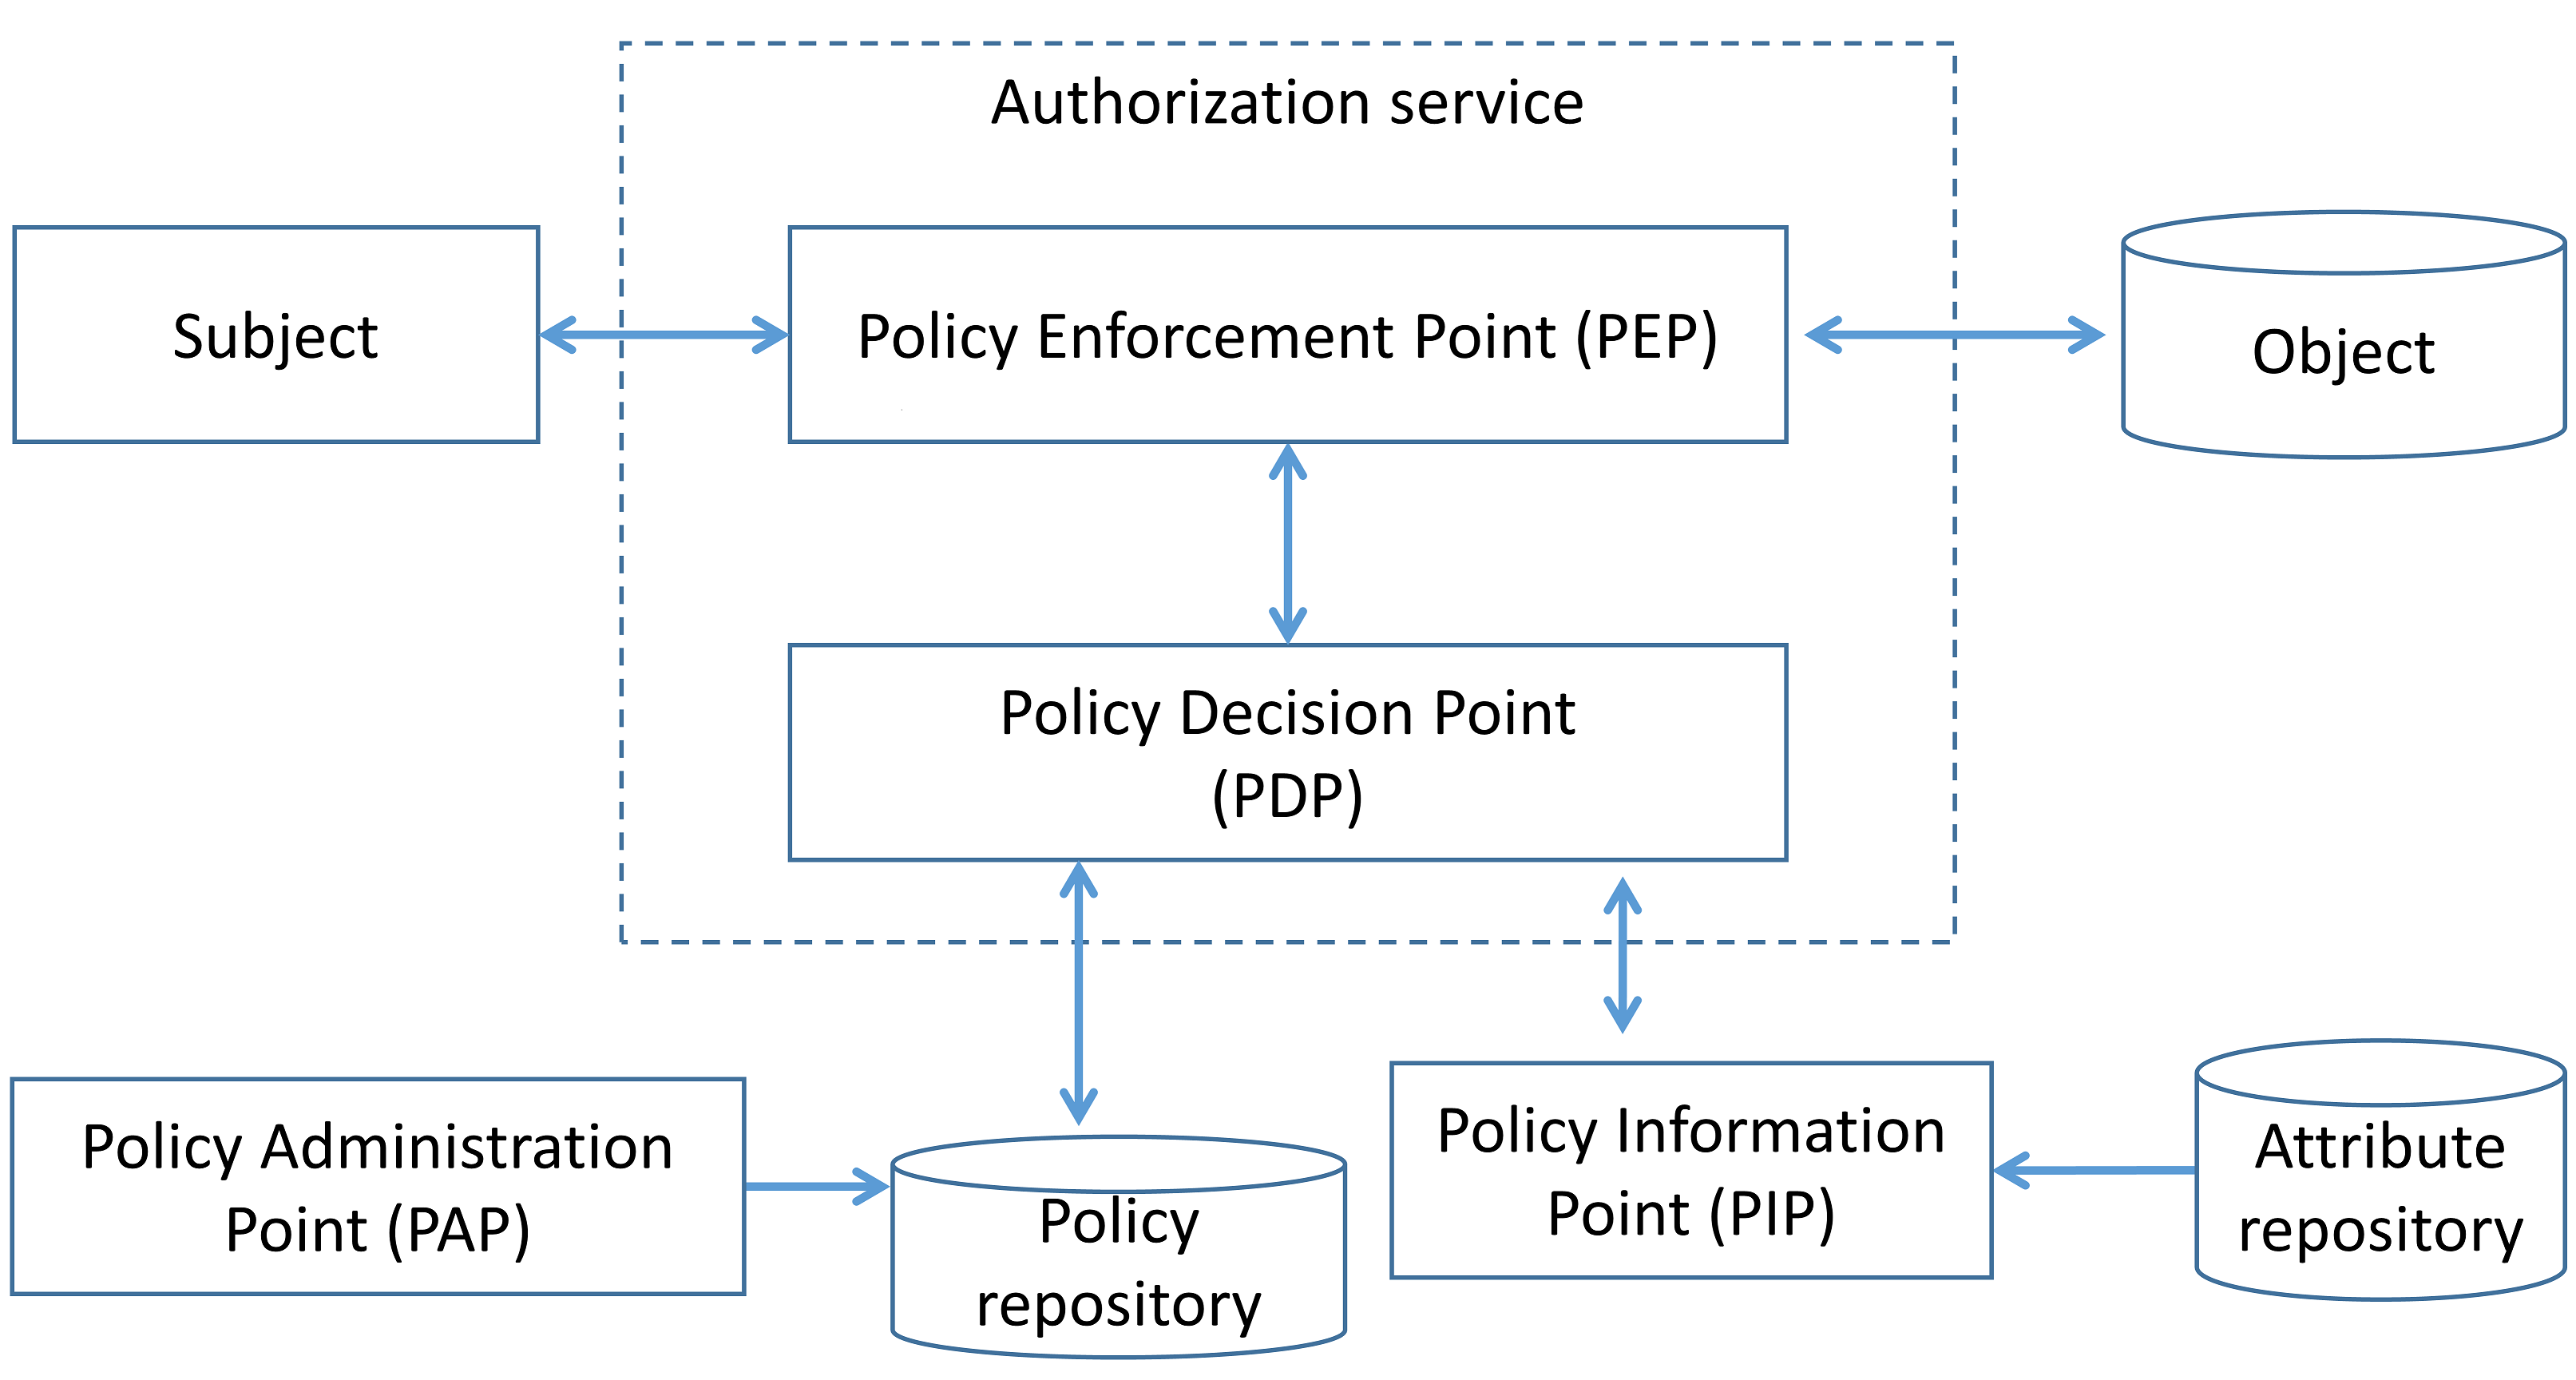
Авторизация на уровне сервиса предоставляет каждому микросервису больше контроля над применением политик контроля доступа. Для дальнейшего обсуждения будем использовать термины и определения согласно NIST SP 800-162. Функциональные компоненты системы контроля доступа можно классифицировать следующим образом:
- Policy Administration Point (PAP): предоставляет пользовательский интерфейс для создания, управления, тестирования и отладки правил контроля доступа.
- Policy Decision Point (PDP): вычисляет решения о доступе путём оценки применимой политики контроля доступа.
- Policy Enforcement Point (PEP): применяет решения политики в ответ на запрос субъекта, запрашивающего доступ к защищённому объекту.
- Policy Information Point (PIP): служит источником получения атрибутов или данных, необходимых для оценки политики, и предоставляет информацию, необходимую PDP для принятия решений.
Авторизация на уровне сервиса: существующие паттерны
Децентрализованный паттерн
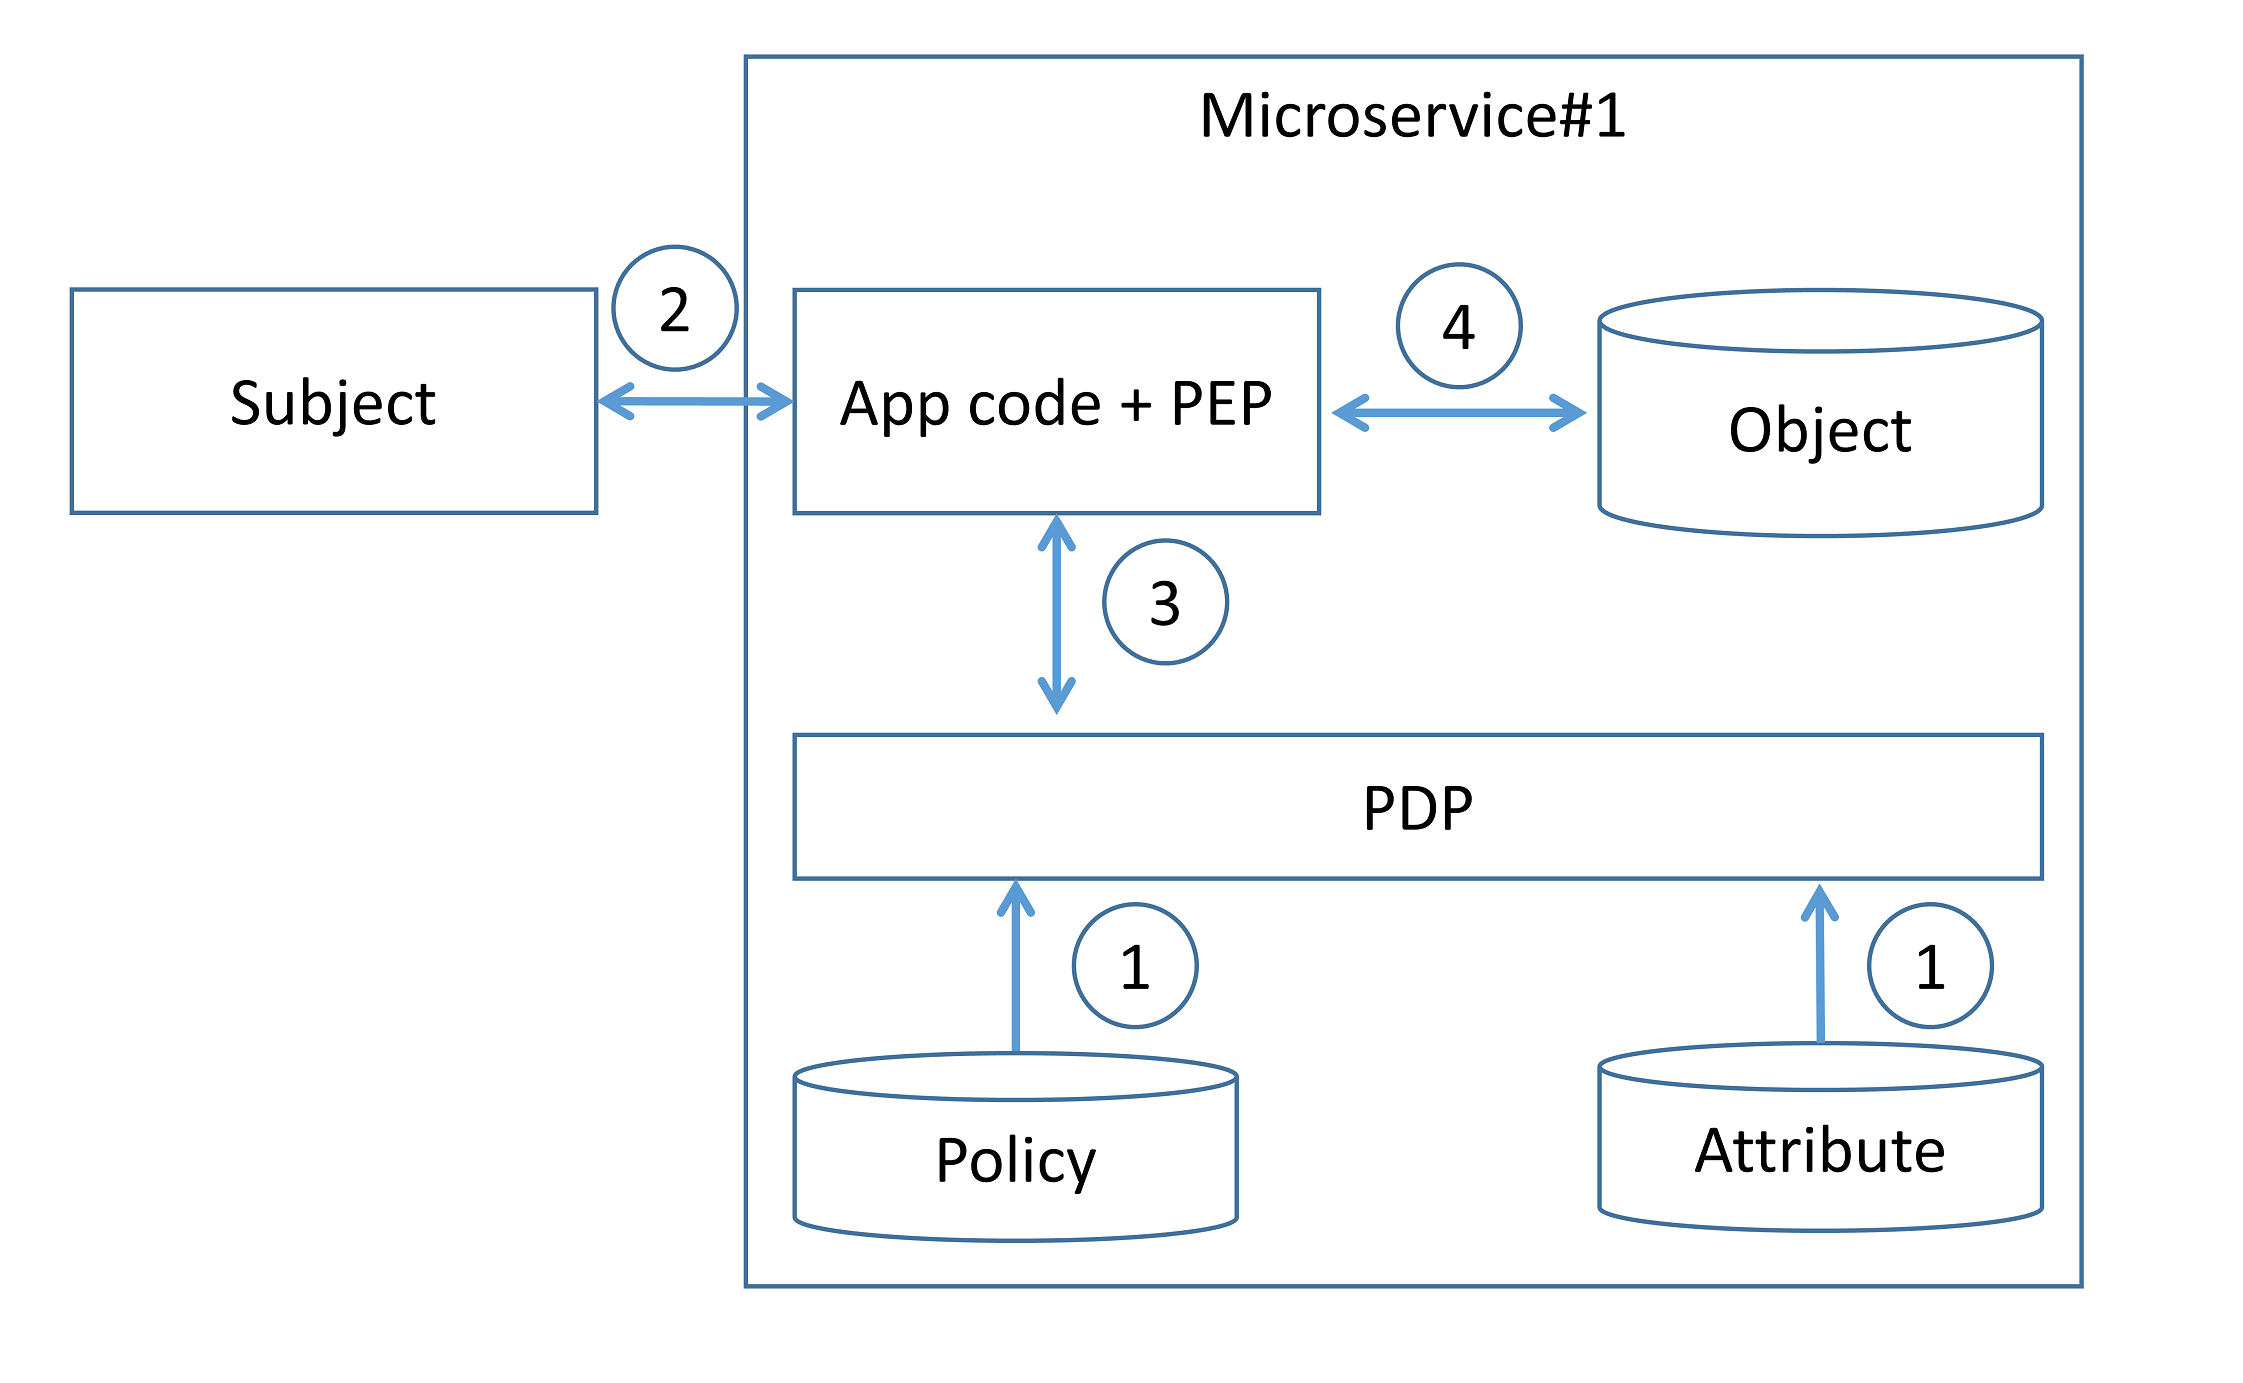
Команда разработчиков реализует PDP и PEP непосредственно на уровне кода микросервиса. Все правила контроля доступа и атрибуты, необходимые для их реализации, определяются и хранятся в каждом микросервисе (шаг 1). Когда микросервис получает запрос вместе с некоторыми метаданными авторизации (например, контекст конечного пользователя или ID запрашиваемого ресурса), микросервис анализирует их (шаг 3), чтобы сформировать решение политики контроля доступа, а затем применяет авторизацию (шаг 4).
Существующие фреймворки языков программирования позволяют командам разработчиков реализовывать авторизацию на уровне микросервиса. Например, Spring Security позволяет разработчикам включить проверку scopes (например, используя scopes, извлечённые из входящего JWT) в resource server и использовать это для применения авторизации.
Реализация авторизации на уровне исходного кода означает, что код необходимо обновлять каждый раз, когда команда разработчиков хочет изменить логику авторизации.
Централизованный паттерн с единой точкой принятия решений
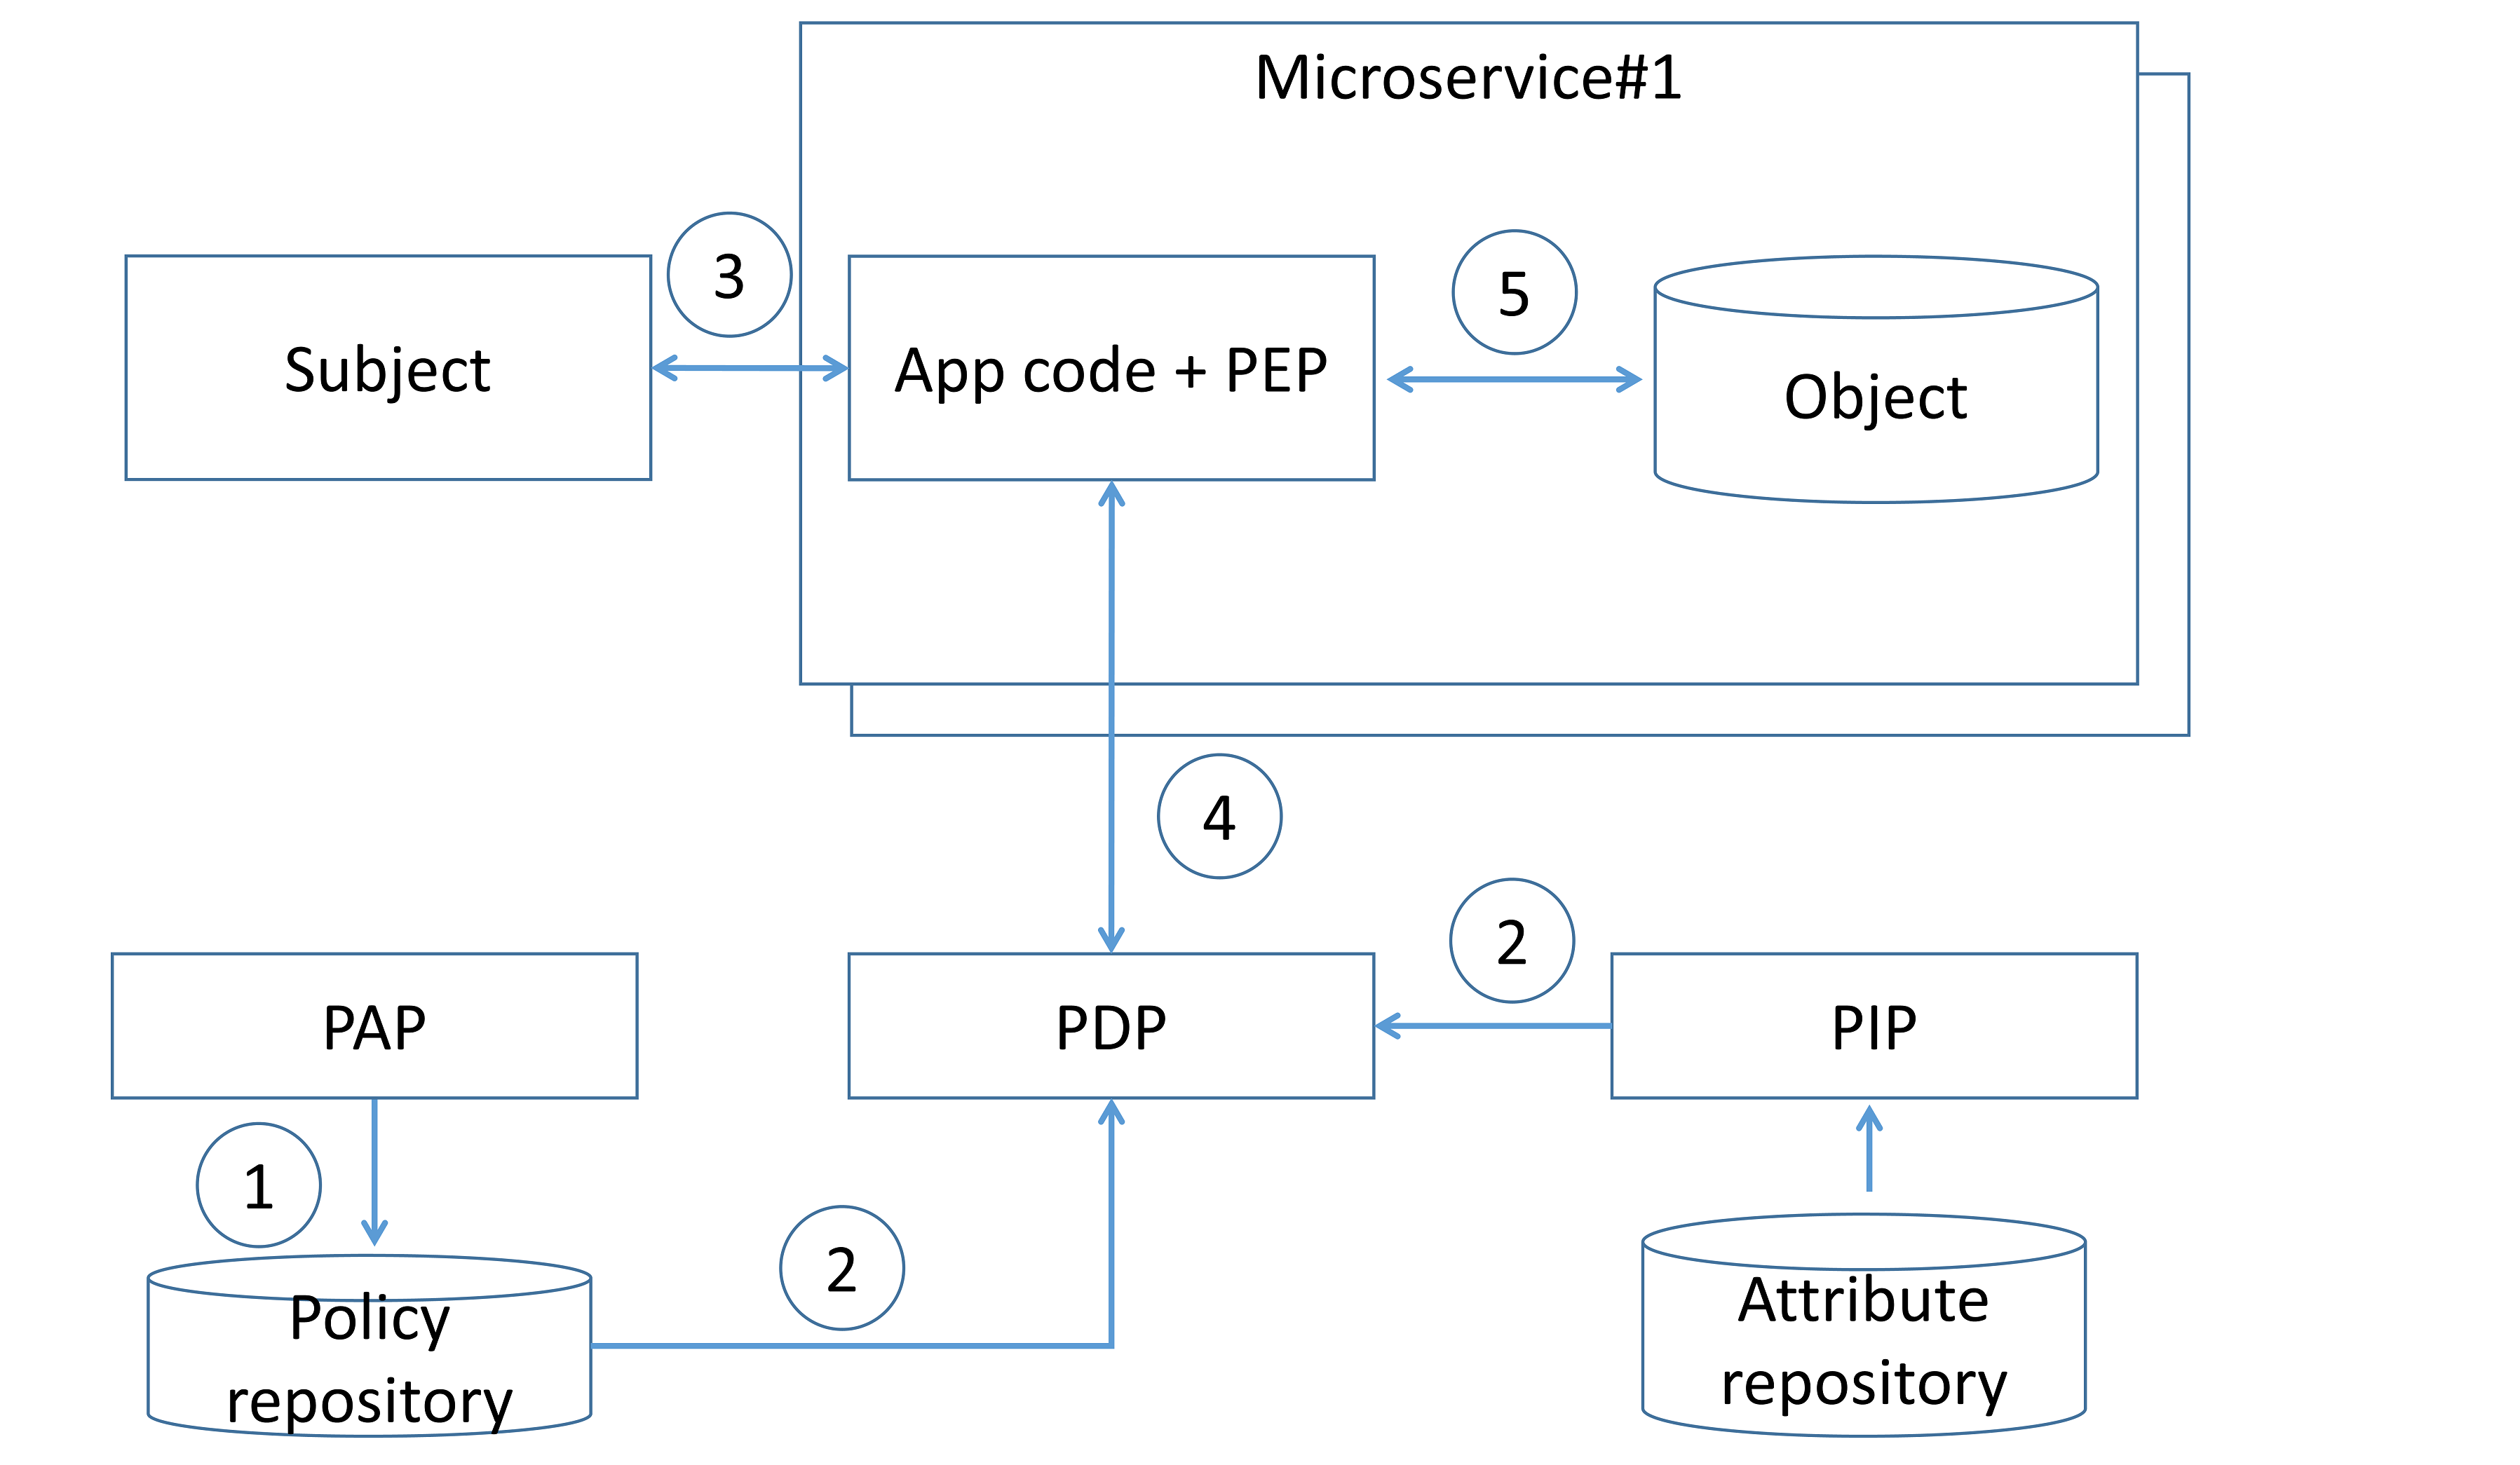
В этом паттерне правила контроля доступа определяются, хранятся и оцениваются централизованно. Правила контроля доступа определяются с помощью PAP (шаг 1) и доставляются в централизованный PDP вместе с атрибутами, необходимыми для их оценки (шаг 2). Когда субъект вызывает endpoint микросервиса (шаг 3), код микросервиса вызывает централизованный PDP через сетевой вызов, и PDP формирует решение политики контроля доступа, оценивая входные данные запроса на соответствие правилам контроля доступа и атрибутам (шаг 4). На основе решения PDP микросервис применяет авторизацию (шаг 5).
Для определения правил контроля доступа команды разработки/эксплуатации должны использовать какой-либо язык или нотацию. Пример — Extensible Access Control Markup Language (XACML) и Next Generation Access Control (NGAC) — стандарт для описания правил политики.
Этот паттерн может вызывать проблемы с задержкой из-за дополнительных сетевых вызовов к удалённому endpoint PDP, но это можно смягчить кешированием решений политики авторизации на уровне микросервиса. Следует отметить, что PDP должен работать в режиме высокой доступности во избежание проблем с устойчивостью и доступностью. Архитекторам безопасности приложений следует сочетать его с другими паттернами (например, авторизацией на уровне API gateway) для соблюдения принципа «глубокоэшелонированной защиты».
Централизованный паттерн со встроенной точкой принятия решений
В этом паттерне правила контроля доступа определяются централизованно, но хранятся и оцениваются на уровне микросервиса. Правила контроля доступа определяются с помощью PAP (шаг 1) и доставляются во встроенный PDP вместе с атрибутами, необходимыми для их оценки (шаг 2). Когда субъект вызывает endpoint микросервиса (шаг 3), код микросервиса вызывает PDP, и PDP формирует решение политики контроля доступа, оценивая входные данные запроса на соответствие правилам контроля доступа и атрибутам (шаг 4). На основе решения PDP микросервис применяет авторизацию (шаг 5).
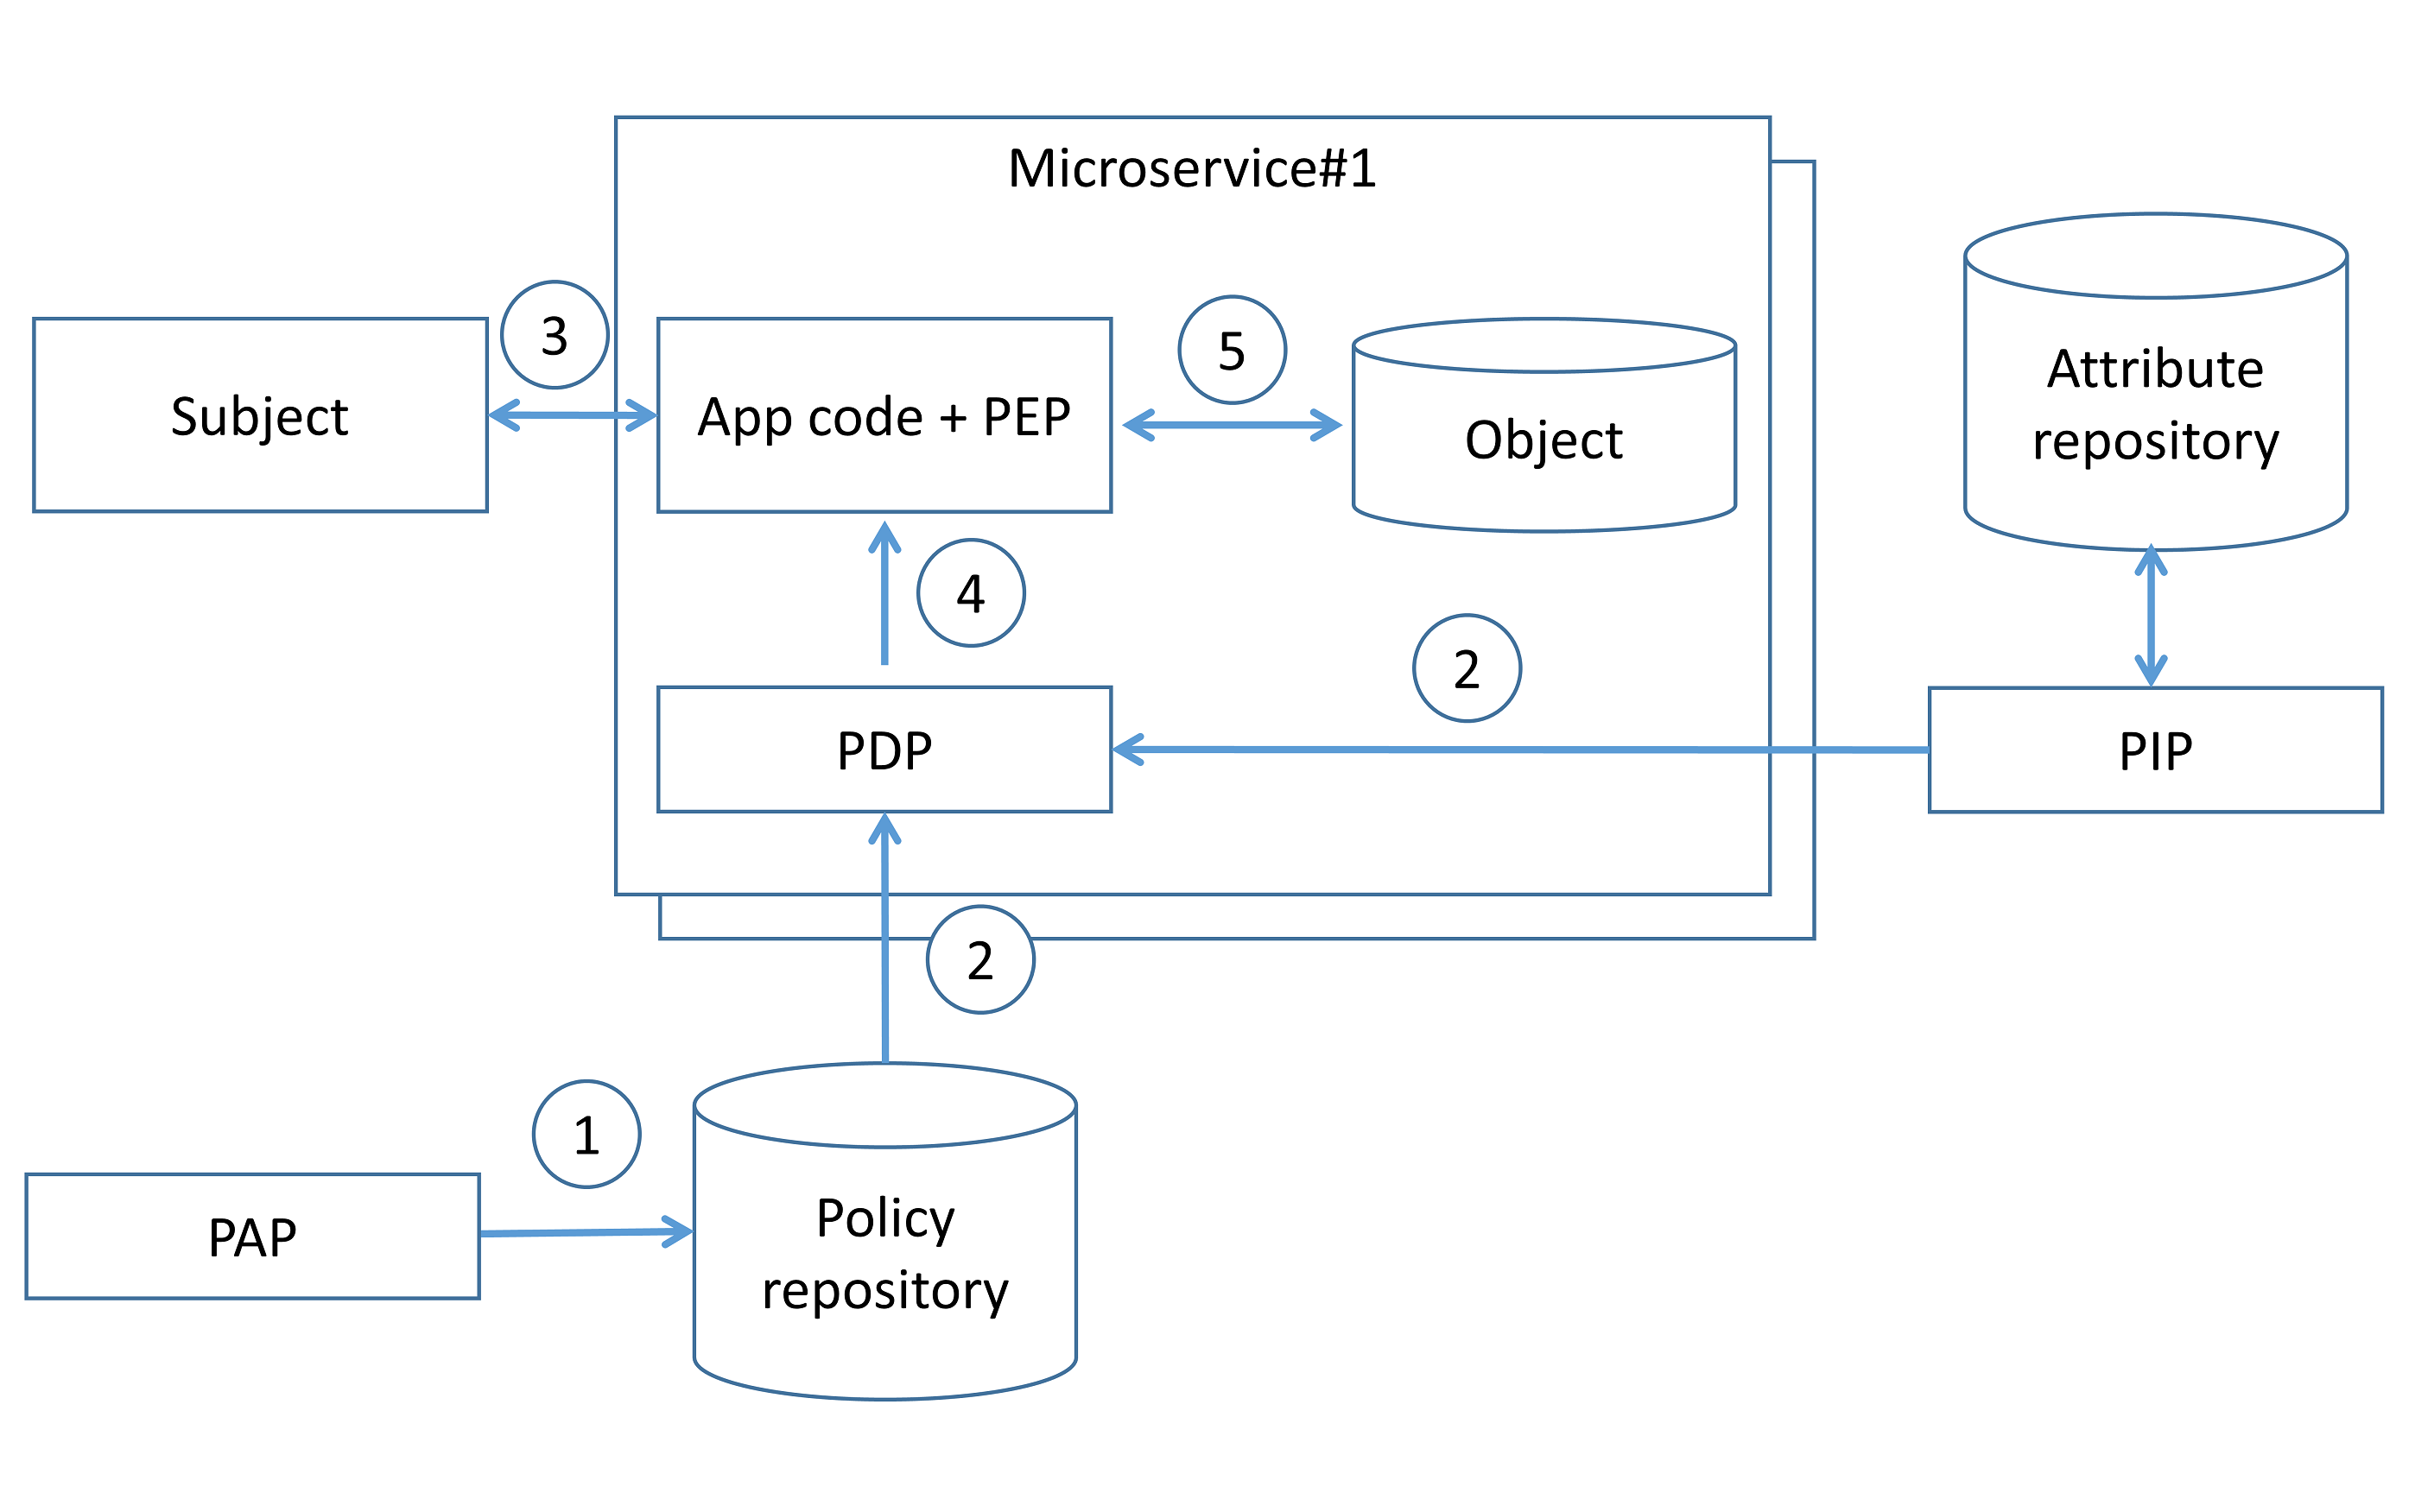
Код PDP в данном случае может быть реализован как встроенная библиотека микросервиса или sidecar в архитектуре service mesh. Из-за возможных сбоев сети/хоста и сетевых задержек рекомендуется реализовывать встроенный PDP как библиотеку микросервиса или sidecar на том же хосте, что и микросервис. Встроенный PDP обычно хранит политику авторизации и связанные с ней данные в памяти для минимизации внешних зависимостей при применении авторизации и обеспечения низкой задержки. Главное отличие от подхода «Централизованный паттерн с единой точкой принятия решений» состоит в том, что решения об авторизации не хранятся на стороне микросервиса — вместо этого там хранится актуальная политика авторизации. Следует отметить, что кеширование решений об авторизации может привести к применению устаревших правил авторизации и нарушениям контроля доступа.
Netflix представил (ссылка, ссылка) реальный случай использования паттерна «Централизованный паттерн со встроенным PDP» для реализации авторизации на уровне микросервисов.
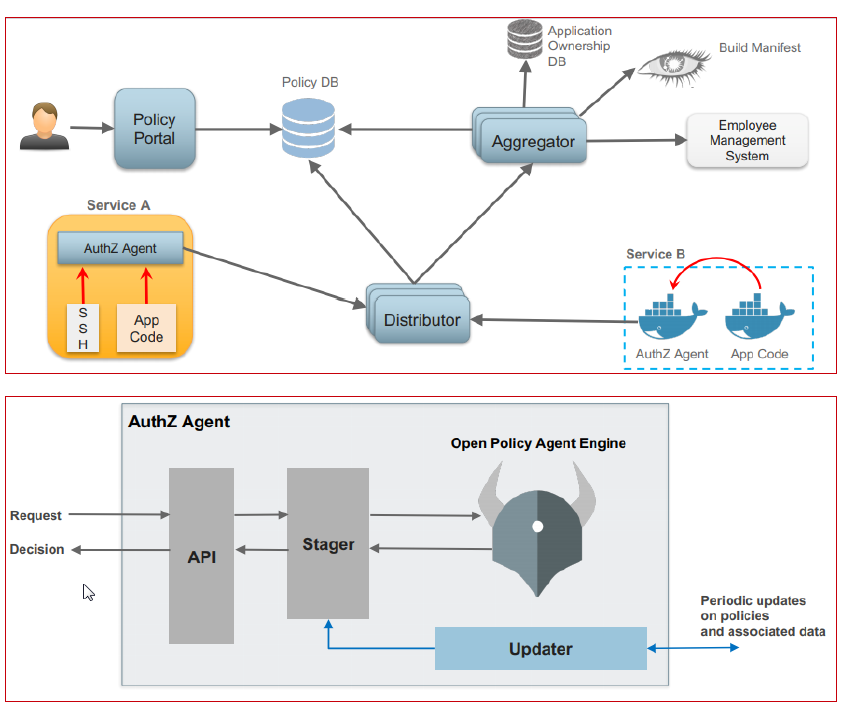
- Policy portal и Policy repository — это UI-системы для создания, управления и версионирования правил контроля доступа.
- Aggregator получает данные, используемые в правилах контроля доступа, из всех внешних источников и поддерживает их актуальность.
- Distributor извлекает правила контроля доступа (из Policy repository) и данные, используемые в правилах контроля доступа (из Aggregators), для их распространения среди PDP.
- PDP (библиотека) асинхронно получает правила контроля доступа и данные и поддерживает их актуальность для применения авторизации компонентом PEP.
Рекомендации по реализации авторизации
- Для обеспечения масштабируемости не рекомендуется хардкодить политику авторизации в исходном коде (децентрализованный паттерн) — вместо этого следует использовать специальный язык для описания политики. Цель состоит в том, чтобы вынести/отделить авторизацию от кода, а не просто поставить на пути запросов gateway/proxy в качестве контрольной точки. Рекомендуемым паттерном для авторизации на уровне сервиса является «Централизованный паттерн со встроенным PDP» ввиду его устойчивости и широкого распространения.
- Решение для авторизации должно быть решением платформенного уровня; специализированная команда (например, команда Platform security) должна нести ответственность за разработку и эксплуатацию решения для авторизации, а также за распространение среди команд разработчиков blueprint/библиотек/компонентов микросервисов, реализующих авторизацию.
- Решение для авторизации должно основываться на широко используемых решениях, поскольку реализация собственного решения имеет следующие недостатки:
- командам безопасности или разработки придётся создавать и поддерживать собственное решение;
- необходимо создавать и поддерживать клиентские библиотеки SDK для каждого языка, используемого в архитектуре системы;
- каждого разработчика нужно обучать работе с API и интеграцией собственного сервиса авторизации, а открытого сообщества для обмена информацией не существует.
- Существует вероятность того, что не все политики контроля доступа могут быть применены через gateway/proxy и общую библиотеку/компоненты авторизации, поэтому некоторые специфические правила контроля доступа всё равно придётся реализовывать на уровне бизнес-кода микросервиса. Для этого рекомендуется, чтобы команды разработчиков микросервисов использовали простые анкеты/чек-листы для выявления таких требований безопасности и их корректной обработки в процессе разработки микросервиса.
- Рекомендуется реализовывать принцип «глубокоэшелонированной защиты» и применять авторизацию на:
- уровне gateway и proxy — на укрупнённом уровне детализации;
- уровне микросервиса — с использованием общей библиотеки/компонентов авторизации для применения детальных решений;
- уровне бизнес-кода микросервиса — для реализации специфических бизнес-правил контроля доступа.
- Для политики контроля доступа должны быть внедрены формальные процедуры разработки, согласования и внедрения.
Распространение идентификатора внешней сущности
Для принятия детальных решений об авторизации на уровне микросервиса микросервис должен понимать контекст вызывающей стороны (например, ID пользователя, роли/группы пользователя). Чтобы позволить уровню внутренних сервисов применять авторизацию, уровень edge должен передавать аутентифицированный идентификатор внешней сущности (например, контекст конечного пользователя) вместе с запросом к нижестоящим микросервисам. Один из простейших способов распространения идентификатора внешней сущности — повторное использование токена доступа, полученного edge, и передача его внутренним микросервисам. Однако следует отметить, что этот подход крайне небезопасен из-за возможной утечки внешнего токена доступа и может увеличить поверхность атаки, поскольку коммуникация опирается на проприетарную реализацию системы на основе токенов. Если внутренний сервис непреднамеренно окажется доступен из внешней сети, к нему можно будет обратиться напрямую с помощью утёкшего токена доступа. Эта атака невозможна, если внутренний сервис принимает только формат токена, известный исключительно внутренним сервисам. Данный паттерн также не является агностическим по отношению к внешним токенам доступа: внутренние сервисы должны понимать внешние токены доступа и поддерживать широкий спектр техник аутентификации для извлечения идентификатора из различных типов внешних токенов (например, JWT, cookie, токен OpenID Connect).
Распространение идентификатора: существующие паттерны
Передача идентификатора внешней сущности в виде открытой или самоподписанной структуры данных
В этом подходе микросервис извлекает идентификатор внешней сущности из входящего запроса (например, путём парсинга входящего токена доступа), создаёт структуру данных (например, JSON или самоподписанный JWT) с этим контекстом и передаёт её внутреннему микросервису. В этом сценарии микросервис-получатель должен доверять вызывающему микросервису. Если вызывающий микросервис захочет нарушить правила контроля доступа, он может сделать это, указав в HTTP-заголовке произвольный ID пользователя/клиента или роли пользователя. Этот подход подходит только для высокодоверенных сред, где каждый микросервис разрабатывается надёжной командой, применяющей практики безопасной разработки программного обеспечения.
Использование структуры данных, подписанной доверенным издателем
В этом паттерне после аутентификации внешнего запроса сервисом аутентификации на уровне edge формируется структура данных, представляющая идентификатор внешней сущности (например, содержащая ID пользователя, роли/группы пользователя или разрешения), которая подписывается или шифруется доверенным издателем и распространяется по внутренним микросервисам.
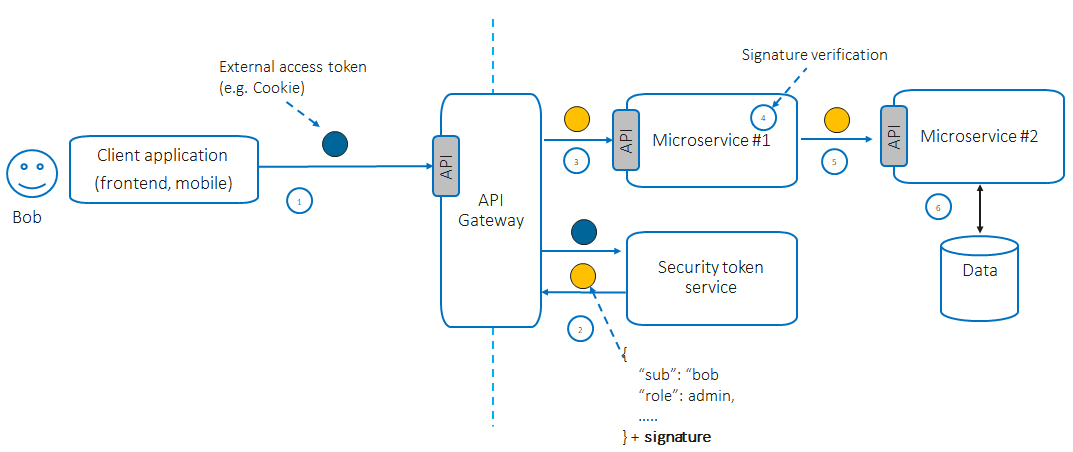
Netflix представил реальный случай применения этого паттерна: структура под названием «Passport», содержащая ID пользователя и его атрибуты, защищается HMAC на уровне edge для каждого входящего запроса. Эта структура распространяется по внутренним микросервисам и никогда не раскрывается вовне.
- Edge Authentication Service (EAS) получает секретный ключ из системы управления ключами (Key Management System).
- EAS получает токен доступа (например, в cookie, JWT, токене OAuth2) из входящего запроса.
- EAS расшифровывает токен доступа, определяет идентификатор внешней сущности и передаёт его внутренним сервисам в подписанной структуре «Passport».
- Внутренние сервисы могут извлекать идентификатор пользователя для применения авторизации (например, для реализации авторизации на основе идентификатора) с помощью обёрток.
- При необходимости внутренний сервис может передавать структуру «Passport» нижестоящим сервисам в цепочке вызовов.
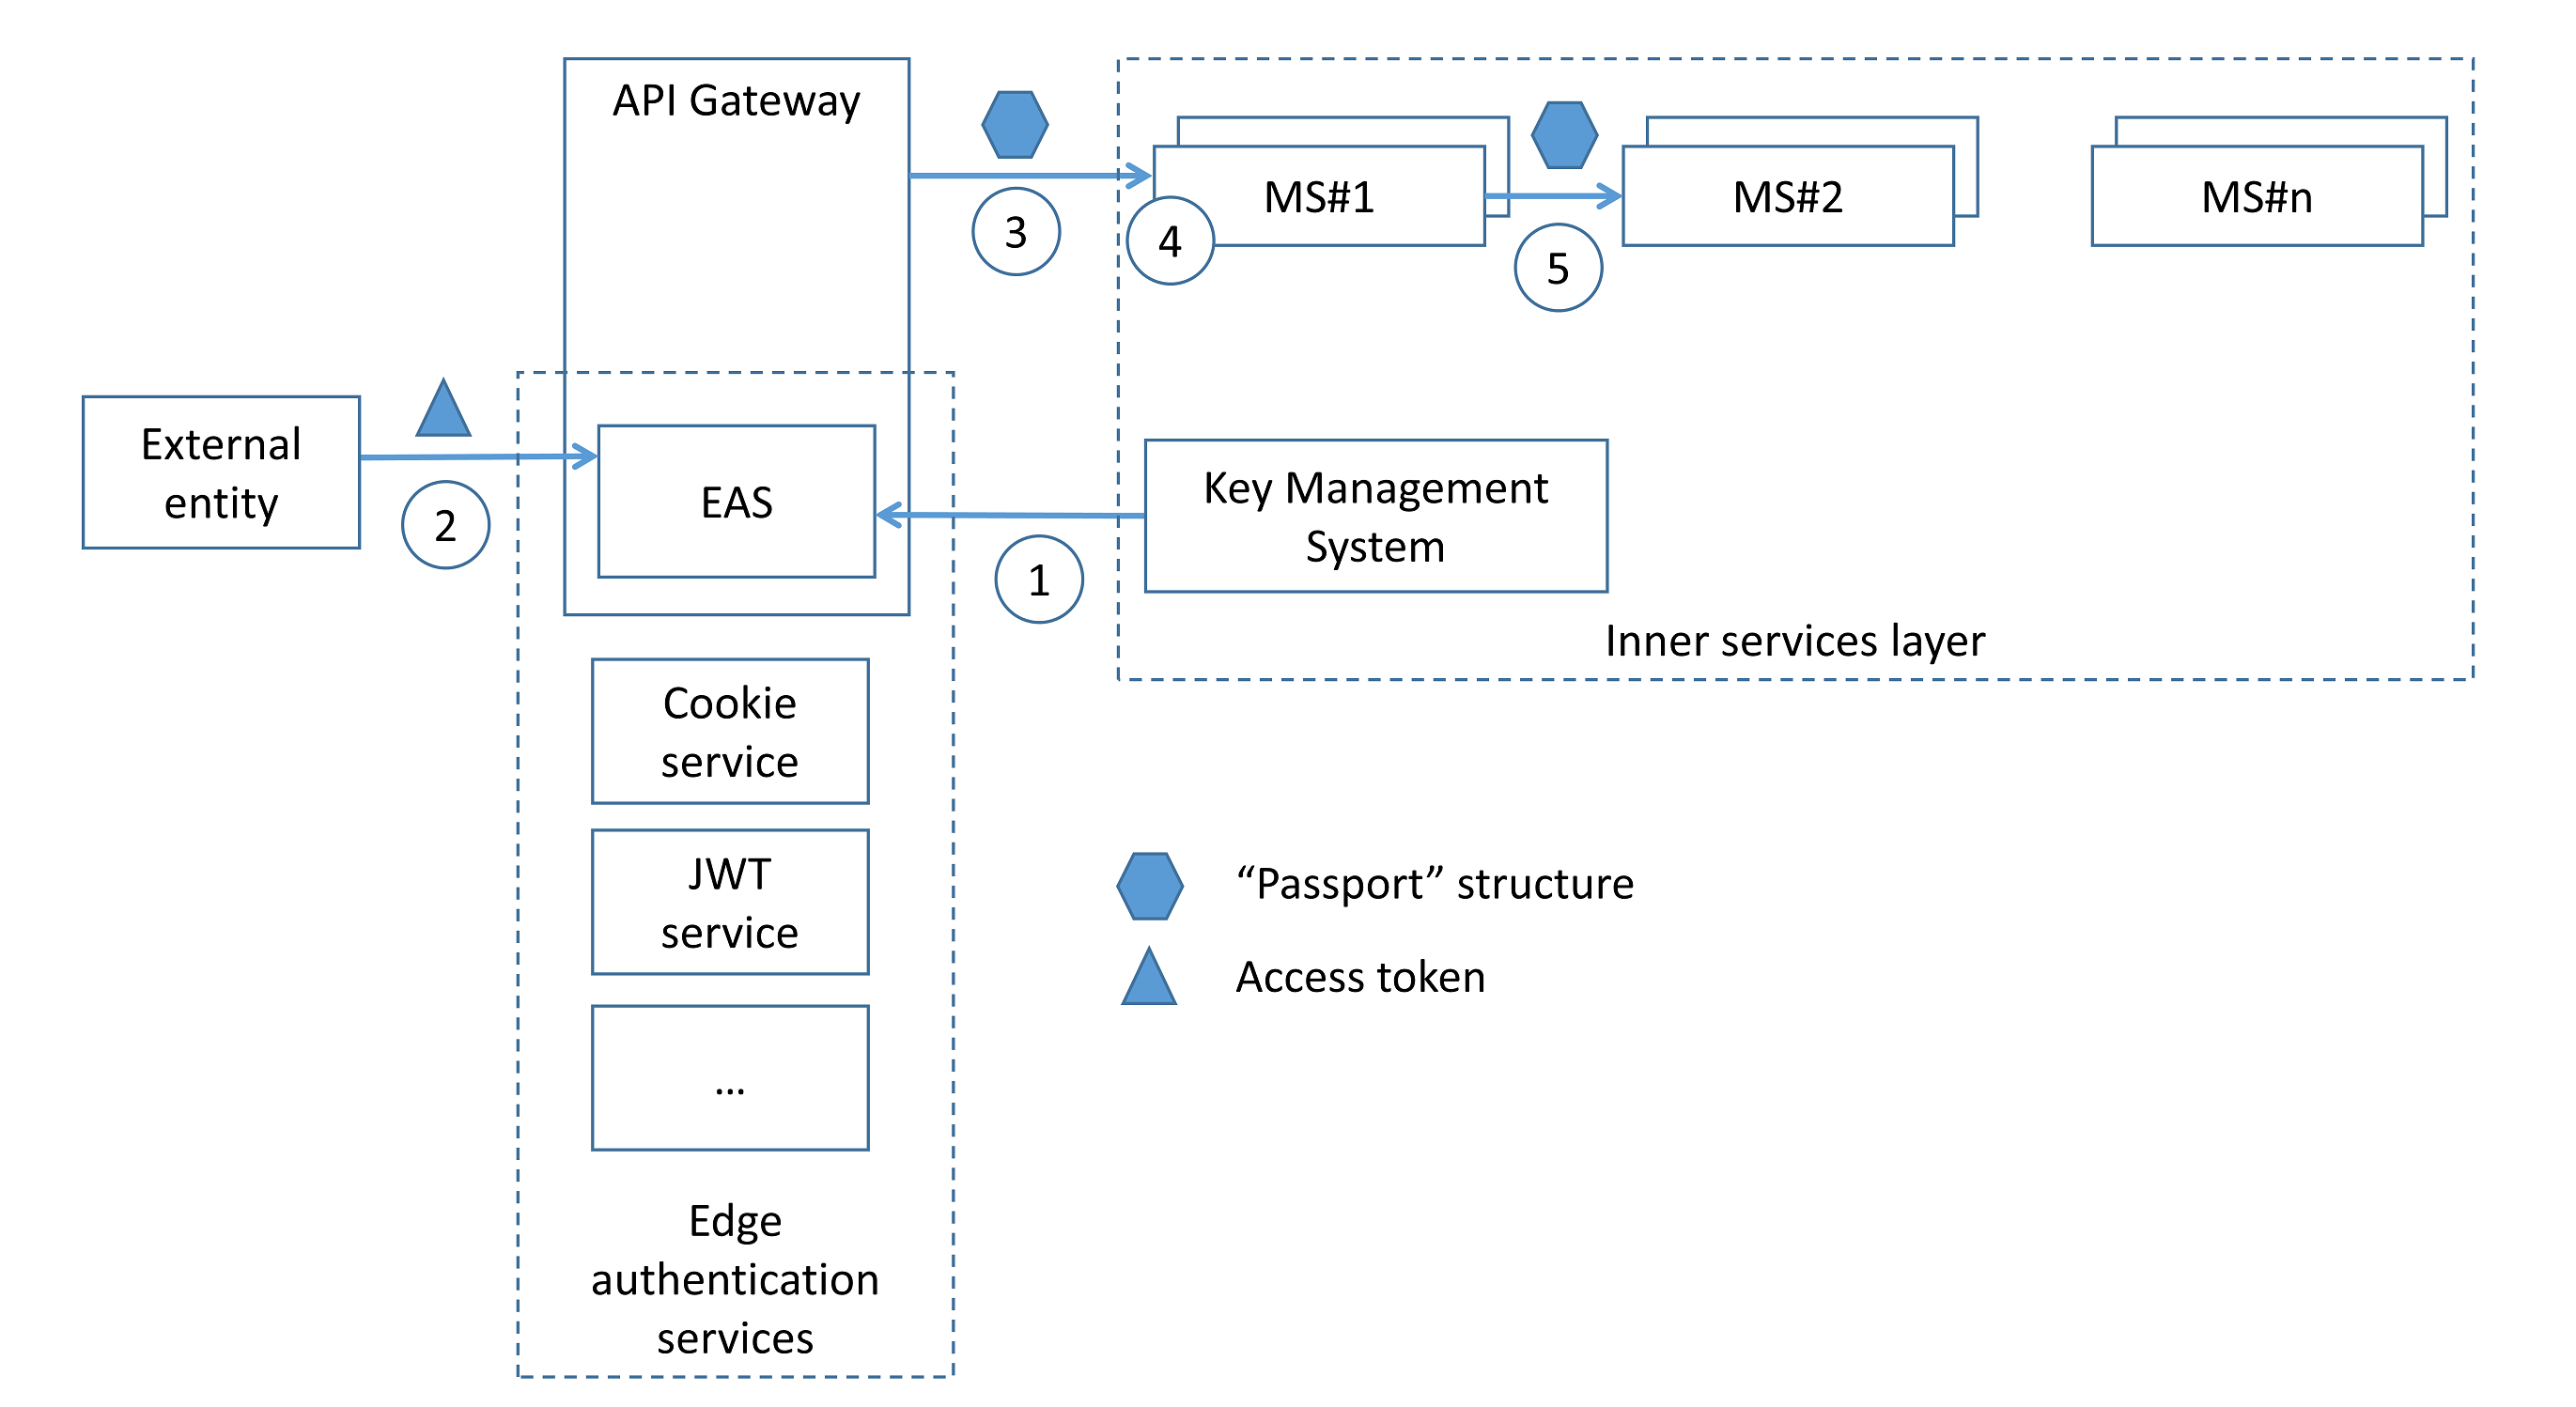 Следует отметить, что паттерн является агностическим по отношению к внешним токенам доступа и позволяет отделить внешние сущности от их внутренних представлений.
Рекомендации по реализации распространения идентификатора
- Для реализации системы, агностической по отношению к внешним токенам доступа и расширяемой, следует отделить токены доступа, выданные для внешней сущности, от её внутреннего представления. Используйте единую структуру данных для представления и распространения идентификатора внешней сущности среди микросервисов. Сервис уровня edge должен проверять входящий внешний токен доступа, формировать структуру внутреннего представления сущности и передавать её нижестоящим сервисам.
- Рекомендуемым паттерном, принятым в сообществе, является использование структуры внутреннего представления сущности, подписанной (симметричное или асимметричное шифрование) доверенным издателем.
- Структура внутреннего представления сущности должна быть расширяемой для возможности добавления дополнительных claims, что может привести к снижению задержки.
- Структура внутреннего представления сущности не должна раскрываться вовне (например, в браузер или внешнее устройство).
Аутентификация между сервисами
Существующие паттерны
Взаимная защита транспортного уровня (mTLS)
При использовании mTLS каждый микросервис может достоверно идентифицировать собеседника, а также обеспечить конфиденциальность и целостность передаваемых данных. Каждый микросервис в развёртывании должен иметь пару публичный/приватный ключ и использовать эту пару ключей для аутентификации перед микросервисами-получателями через mTLS. mTLS обычно реализуется с помощью самостоятельно размещаемой инфраструктуры открытых ключей (Public Key Infrastructure). Основными проблемами при использовании mTLS являются подготовка ключей и начальная установка доверия (trust bootstrap), отзыв сертификатов и ротация ключей.
На основе токенов
Подход на основе токенов работает на прикладном уровне. Токен — это контейнер, который может содержать ID вызывающей стороны (ID микросервиса) и её разрешения (scopes). Вызывающий микросервис может получить подписанный токен, обратившись к специальному сервису безопасных токенов (security token service) с использованием собственного ID и пароля сервиса, а затем прикрепляет его к каждому исходящему запросу, например через HTTP-заголовки. Вызываемый микросервис может извлечь токен и проверить его онлайн или офлайн.
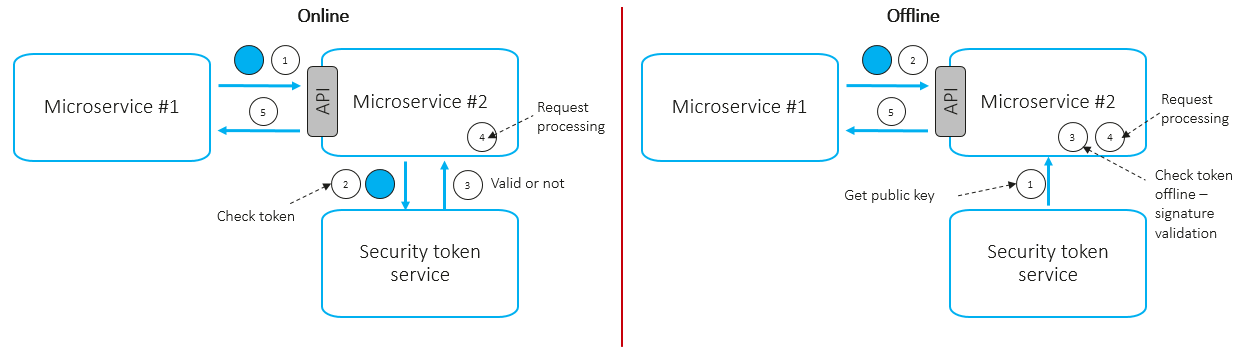
- Онлайн-сценарий:
- Для проверки входящих токенов микросервис обращается к централизованному сервису токенов через сетевой вызов.
- Отозванные (скомпрометированные) токены могут быть обнаружены.
- Высокая задержка.
- Следует применять для критичных запросов.
- Офлайн-сценарий:
- Для проверки входящих токенов микросервис использует загруженный публичный ключ сервиса токенов.
- Отозванные (скомпрометированные) токены могут быть не обнаружены.
- Низкая задержка.
- Следует применять для некритичных запросов. В большинстве случаев аутентификация на основе токенов работает поверх TLS, который обеспечивает конфиденциальность и целостность данных при передаче.
Логирование
Сервисы логирования в системах на основе микросервисов направлены на соблюдение принципов подотчётности и прослеживаемости и помогают обнаруживать аномалии безопасности в операционной деятельности с помощью анализа логов. Поэтому для архитекторов безопасности приложений крайне важно понимать и адекватно использовать существующие архитектурные паттерны для реализации аудит-логирования в системах на основе микросервисов. Высокоуровневый архитектурный дизайн показан на рисунке ниже и основан на следующих принципах:
- Каждый микросервис записывает лог-сообщение в локальный файл через стандартный вывод (stdout, stderr).
- Агент логирования периодически получает лог-сообщения и отправляет (публикует) их в брокер сообщений (например, NATS, Apache Kafka).
- Центральный сервис логирования подписывается на сообщения в брокере, получает и обрабатывает их.
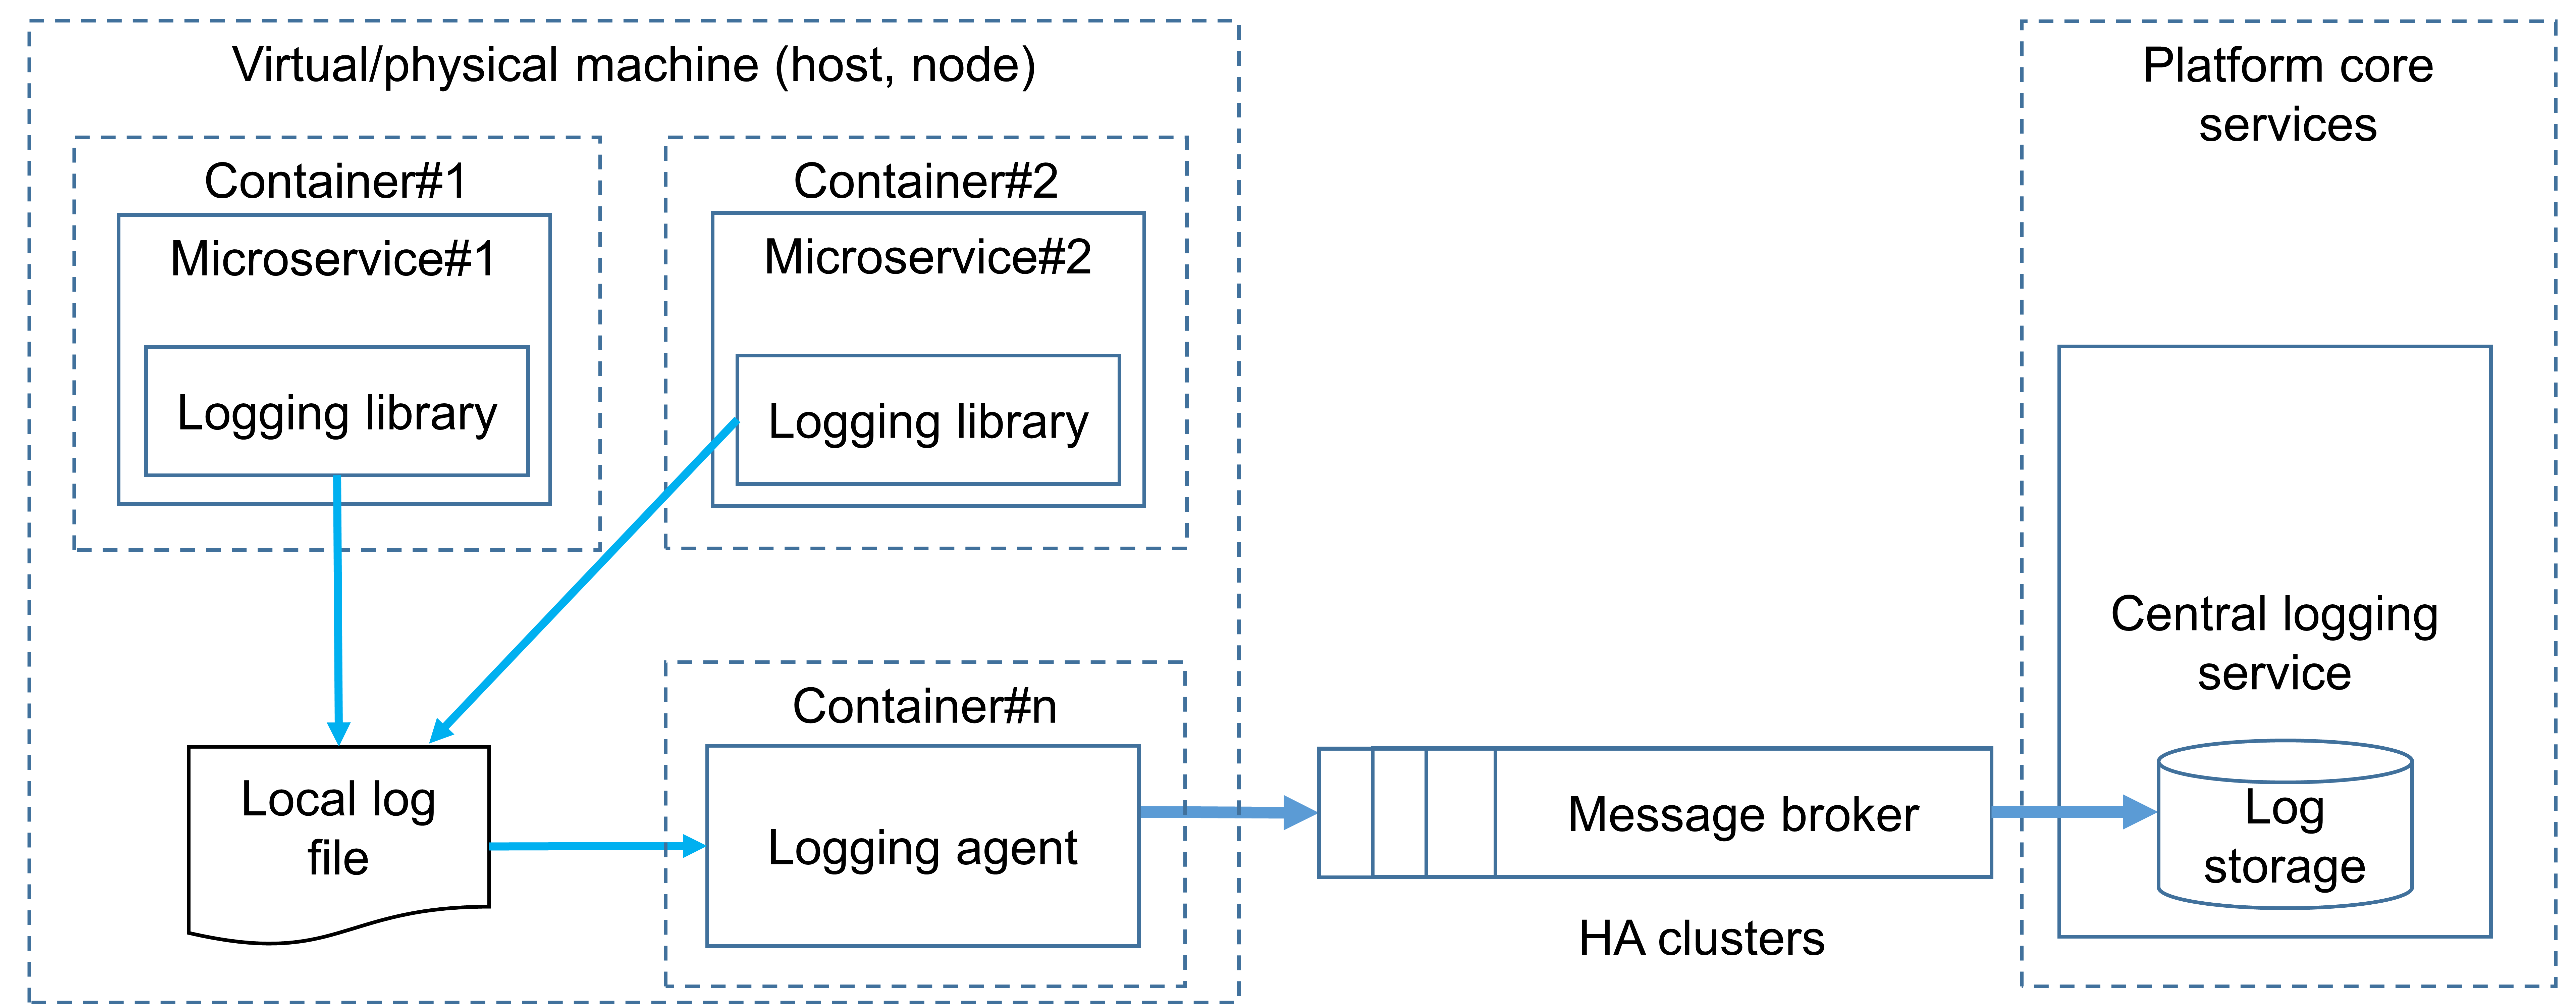
Ниже приведены высокоуровневые рекомендации по архитектуре подсистемы логирования с обоснованиями.
- Микросервис не должен отправлять лог-сообщения напрямую в центральную подсистему логирования по сети. Микросервис должен записывать лог-сообщения в локальный лог-файл:
- это позволяет снизить угрозу потери данных из-за сбоя сервиса логирования в результате атаки или его перегрузки легитимным микросервисом;
- в случае недоступности сервиса логирования микросервис будет продолжать записывать лог-сообщения в локальный файл (без потери данных), и после восстановления сервиса логирования логи будут доступны для отправки;
- Должен существовать выделенный компонент (агент логирования), отделённый от микросервиса. Агент логирования должен собирать лог-данные на микросервисе (читать локальный лог-файл) и отправлять их в центральную подсистему логирования. Из-за возможных проблем с сетевой задержкой агент логирования должен быть развёрнут на том же хосте (виртуальной или физической машине), что и микросервис:
- это позволяет снизить угрозу потери данных из-за сбоя сервиса логирования в результате атаки или его перегрузки легитимным микросервисом;
- в случае сбоя агента логирования микросервис продолжает записывать информацию в лог-файл; после восстановления агент прочитает файл и отправит информацию в брокер сообщений;
- Из-за возможной DoS-атаки на центральную подсистему логирования агент логирования не должен использовать асинхронный паттерн запрос/ответ для отправки лог-сообщений. Для реализации асинхронного соединения между агентом логирования и центральным сервисом логирования должен использоваться брокер сообщений:
- это позволяет снизить угрозу потери данных из-за сбоя сервиса логирования при его перегрузке легитимным микросервисом;
- в случае недоступности сервиса логирования микросервис будет продолжать записывать лог-сообщения в локальный файл (без потери данных), и после восстановления сервиса логирования логи будут доступны для отправки;
- Агент логирования и брокер сообщений должны использовать взаимную аутентификацию (например, на основе TLS) для шифрования всех передаваемых данных (лог-сообщений) и взаимной аутентификации:
- это позволяет снизить такие угрозы, как: спуфинг микросервиса, спуфинг системы логирования/транспорта, инъекция сетевого трафика, прослушивание сетевого трафика;
- Брокер сообщений должен применять политику контроля доступа для предотвращения несанкционированного доступа и реализации принципа наименьших привилегий:
- это позволяет снизить угрозу повышения привилегий микросервиса;
- Агент логирования должен фильтровать/санировать исходящие лог-сообщения, чтобы гарантировать, что конфиденциальные данные (например, PII, пароли, API-ключи) никогда не попадают в центральную подсистему логирования (принцип минимизации данных). Для полного обзора элементов, которые следует исключать из логов, см. OWASP Logging Cheat Sheet.
- Микросервисы должны генерировать correlation ID, который уникально идентифицирует каждую цепочку вызовов и помогает группировать лог-сообщения для их расследования. Агент логирования должен включать correlation ID в каждое лог-сообщение.
- Агент логирования должен периодически предоставлять данные о состоянии и статусе для индикации своей доступности или недоступности.
- Агент логирования должен публиковать лог-сообщения в структурированном формате (например, JSON, CSV).
- Агент логирования должен дополнять лог-сообщения контекстными данными, например контекстом платформы (имя хоста, имя контейнера), контекстом выполнения (имя класса, имя файла).
Для полного обзора событий, которые следует логировать, и возможных форматов данных см. OWASP Logging Cheat Sheet и Application Logging Vocabulary Cheat Sheet.
Ссылки
- NIST Special Publication 800-204 "Security Strategies for Microservices-based Application Systems"
- NIST Special Publication 800-204A "Building Secure Microservices-based Applications Using Service-Mesh Architecture"
- Microservices Security in Action, Prabath Siriwardena and Nuwan Dias, 2020, Manning